引言
在人工智能基礎軟件開發中,計算架構的選擇直接影響模型訓練與推理的效率。圖形處理器(GPU)和張量處理器(TPU)是當前主流的兩種加速硬件。本文從架構設計、編程模型、軟件生態及適用場景等方面對二者進行比較,為人工智能基礎軟件的開發者提供參考。
1. 計算架構對比
1.1 GPU 架構特點
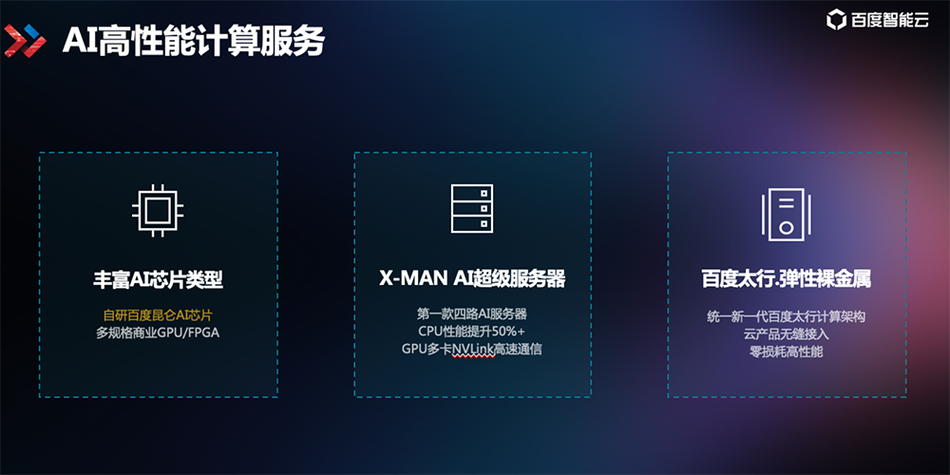
GPU 采用大規模并行計算架構,擁有數千個流處理器(CUDA Core 或 Stream Processor),適合高吞吐量的通用并行計算。其內存層次包括全局內存、共享內存、寄存器等,支持細粒度線程級并行。現代 GPU 還集成了張量核心(Tensor Core),專門加速矩陣乘加運算。
1.2 TPU 架構特點
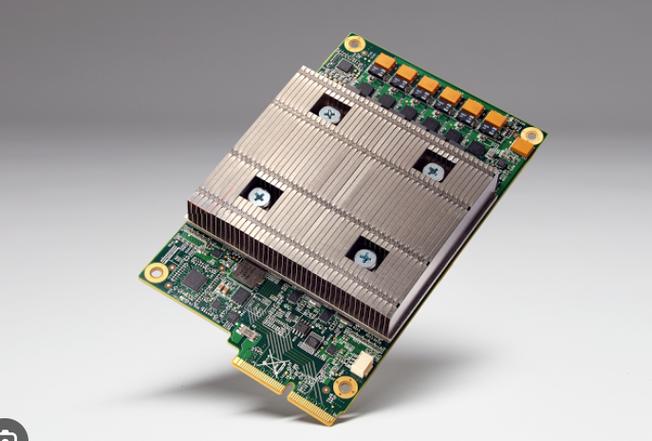
TPU 是專為神經網絡計算設計的專用集成電路(ASIC)。其核心是脈動陣列(Systolic Array),以高度并行的方式執行矩陣乘法。TPU 采用大容量片上內存(如 128MB 的全局內存),減少對片外內存的訪問,并通過量化技術(如 INT8)提升能效。TPU 通常以板卡或 Pod 形式部署,通過專用互連實現大規模擴展。
1.3 關鍵差異
- 并行模式:GPU 為 SIMT(單指令多線程),靈活但控制復雜;TPU 為脈動陣列,數據流規整,適合規則計算。
- 內存訪問:GPU 依賴多級緩存和顯存帶寬;TPU 強調片上數據復用,降低訪存開銷。
- 精度支持:GPU 支持 FP32/FP16/BF16/INT8 等多種精度;TPU 側重 BF16/INT8,對低精度優化更深。
2. 編程模型與軟件棧
2.1 GPU 軟件生態
- 編程接口:CUDA(NVIDIA)和 ROCm(AMD)提供底層編程能力;OpenCL 為跨平臺方案。
- 高層框架:TensorFlow、PyTorch 等通過 cuDNN、cuBLAS 等庫調用 GPU 加速。
- 靈活性:開發者可定制核函數,優化特定算子,適合研究探索和自定義模型。
2.2 TPU 軟件生態
- 編程接口:通過 XLA(加速線性代數)編譯器將高層框架的計算圖編譯為 TPU 指令。
- 框架支持:TensorFlow 原生支持 TPU;PyTorch 通過 XLA 橋接支持。
- 使用方式:通常以云計算服務形式提供(如 Google Cloud TPU),開發者通過 API 調用。
- 限制:定制化程度較低,不適配非矩陣運算密集的模型。
2.3 基礎軟件開發考量
- 算子庫:GPU 生態擁有豐富的優化算子庫;TPU 依賴 XLA 自動編譯,對動態形狀支持有限。
- 調試與性能分析:GPU 工具鏈(如 Nsight)成熟;TPU 性能分析工具相對較少。
- 部署靈活性:GPU 可本地部署,TPU 多依賴云服務。
3. 適用場景與選擇建議
3.1 GPU 適用場景
- 需要高度定制化模型或自定義算子的研究。
- 多模態任務、動態計算圖、小批量推理等不規則計算。
- 本地開發和小規模部署。
3.2 TPU 適用場景
- 大規模矩陣運算密集的模型(如 Transformer、CNN)訓練。
- 對能效和成本敏感的大規模推理。
- 已基于 TensorFlow/XLA 構建的流水線。
3.3 選擇建議
在人工智能基礎軟件開發中,若追求靈活性和生態豐富度,GPU 是穩妥選擇;若模型規整且需極致性能功耗比,可考慮 TPU。混合使用(如 GPU 訓練、TPU 推理)也成為趨勢。
結論
GPU 和 TPU 代表了通用并行與專用加速兩種設計哲學。理解其架構差異和軟件生態特點,有助于在人工智能基礎軟件開發中做出合理的技術選型,并針對性地優化軟件棧,充分發揮硬件潛力。隨著編譯技術(如 XLA、MLIR)的發展,二者在軟件層面的界限正逐漸模糊,未來基礎軟件將更注重跨架構的抽象與自動優化。